投机解码
现代LLM的工作阶段一般分为预填充(Prefill)阶段和推理(Decode)阶段。
前者是GPU发挥最大算力的最佳阶段,而后者从token序列的角度上来看,是逐token串行的,因此前向传播退化为矩阵-向量乘法,GPU实际上计算单元是空闲的。
这也是为什么实际工业提出了PD结耦的概念:当Prefill阶段需要更多计算单元(compute-bound)、Decoder阶段需要更大带宽时(memory-bandwidth-bound),将两者放在各自适配的设备上明显更加合理。
当然,本文主要讨论投机解码的解决方式,聚焦于投机解码是如何解决一般推理过程中计算单元的利用率问题,以及如何确保最终的推理与原推理相比是无偏的。
基本思路
投机解码的基本思想,就是先通过小模型的低质量预测草稿,为大模型提供能够对这部分草稿Token序列进行并行验证。
对于草稿序列的每一个Token,Decoder实际上都会经过Softmax、Top-K或Top-P方法产生一个最终所有候选token的概率分布(Prefill阶段使用最后一个token的采样选择第一个输出的token,而投机解码方法会使用每一个概率),投机解码会对照大模型采样到该token的概率与小模型采样到该token的概率,建立接受-拒绝采样,接受概率为:
$$\alpha(x)=min(1,\frac{P(X_{big})}{P(X_{small})}) $$
这一概率乍一看有点让人摸不着头脑,但是实际上却是非常合理的,并且这一概率采样加上接下来拒绝后的再采样构造出来的整体采样概率分布与原模型完全相同。这一点在后文进行简单的介绍和推导。
从第一个被拒绝的token开始,后续的草稿token都会被丢弃。
然后:既然前文都被接受,那么首个被拒绝的token可以原地为其实际采样并替换,采样概率公式为:
$$P(X_i)=\frac{P(X_{i,big})-P(X_{i,small})}{\sum_j max(0,P(X_{j,big}-P(X_{j,small}))} $$
结合上面的接受概率可以看出投机解码的基本思路:
- 将草稿token分为两种:
- 草稿模型大于或等于原模型的token集合A(草稿模型概率分配刚好或过多)
- 草稿模型概率小于原模型概率的token集合B(草稿模型概率分配不够)
- 对于A小模型概率高出的部分,被按比例拒绝,并通过残差分布,按比例分配给B
原理简述
投机并行验证
投机解码实际上最主要的作用就是提高推理效率,通过支付一个小的草稿模型的开销,使得大模型可以从串行的可靠token生成转变为草稿模型的tokens并行验证,从而提高推理效率。
投机并行的性能提升来自两个方面:
-
一方面,GPU、NPU等专用设备实际上在微观上计算的耗时并不是线性增长的。当计算任务无法喂满计算单元时,计算的总耗时不变,譬如一个CUDA的warp计算16或32个元素的向量加的耗时是相同的,主要的时间增长来自数据传输。投机解码能够在单位时间内并行处理更多token,因此效率提升。
-
另一方面,作为使能投机解码的结构,小模型的性能要求其实并不高,串行生产n个token后,通过一次大模型的前向传播,最终接受m个token,产生m+1个token。时间的差如下:
$$T_{sd}=n\times t_{small}+t_{big}'\\ T_{ori}=(m+1)t_{big}\\ $$
其中大模型验证的耗时实际是要略高于单次生成的,但这部分增长相较m个token的快速验证,几乎是九牛一毛。
非朴素的验证拒绝设计和残差采样
有一个很自然的问题:该如何确定大模型是否接受小模型的草稿?大模型的验证方式决定了接受的概率以及投机解码加速推理是否无偏。接下来分享一下笔者初识时产生的错误猜想
一个自然的想法是:将大模型是否“认可”小模型草稿视为一个贝叶斯后验问题,按后验概率决定是否接受。可以证明这种方式最终分布是无偏的,但接受率会显著低于投机解码的最优设计,因此效率不高。
$$\begin{align} P(A_i)&=P(B_i)P(A_i|B_i)+\sum_{j\ne i} P(B_j)P(A_i|B_j)\\ &=P(B_i)P(A_i)+\sum_{j\ne i}P(B_j)P(A_i)=P(A_i) \end{align} $$
那么正确的做法是怎么编排的呢?通过图可以更好的看出接受概率和残差采样是怎么来的。
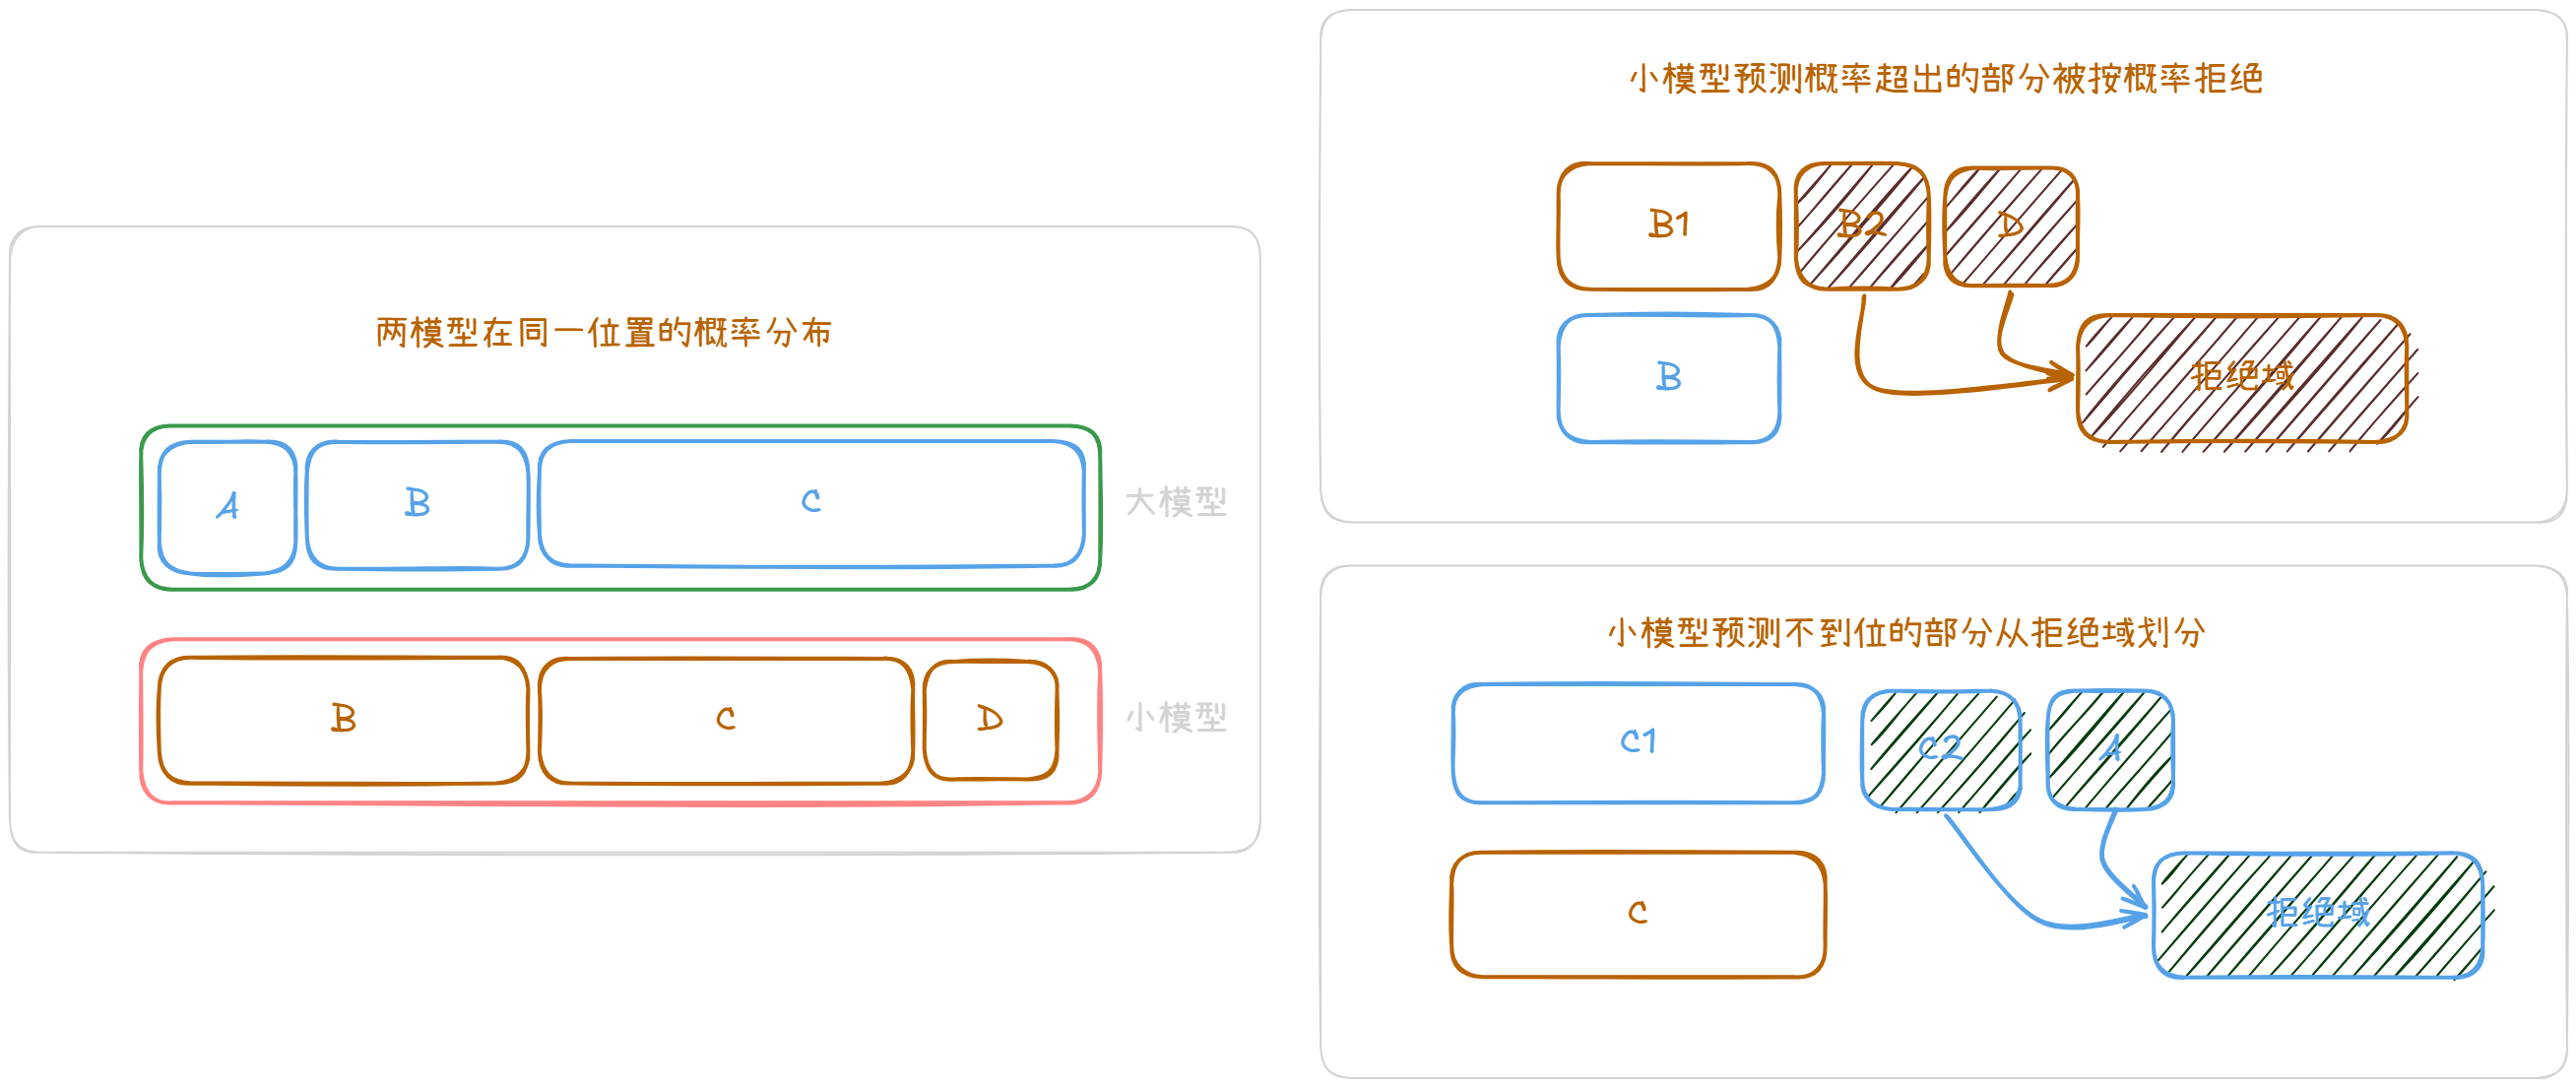
图中B1在原B中占比、C2在拒绝域中的占比可以自行试算,与上文的接受概率、残差概率是刚好一一对应的。
同时,可以看出,草稿若生成C那么一定会被接受,如果生成D一定会被拒绝,这种处理方式最大化了每个token的接受概率,因此是最佳的。
同时可以证明原采样是无偏的:
$$P(X)=P(X_{small})\alpha(X_{small})+\sum P(Y_{small})(1-\alpha(Y_{small}))\frac{ max(0,X_{big}-X_{small})}{\sum max(0,Y_{big}-Y_{small})}\\ 将\alpha展开可得\\ P(X)=min(P(X_{big}),P(X_{small}))+\sum max(0,Y_{big}-Y_{small})\frac{ max(0,X_{big}-X_{small})}{\sum max(0,Y_{big}-Y_{small})}\\ P(X)=min(P(X_{big}),P(X_{small}))+max(0,X_{big}-X_{small})\\ P(X)=P(X_{big}) $$
因此,投机解码是无偏的。
延申
投机解码的很多细节都是值得深究的,譬如草稿的长度、草稿模型的选择、草稿性能和准确度的平衡等等。
目前,上述问题的一般解决方式有基于熵的动态草稿长度和基于同系列低参数模型的草稿模型选择。