CUDA编程 CUDA是NVIDIA提供的GPU专用的编程语言,是将GPU从图形学相关计算专用设备推广到通用计算平台的关键桥梁,虽然Triton已经大幅度简化了算子编程的难度和开发周期,并且LLM在这方面的能力也已经达到了Expert的境界,但无论如何,通过CUDA了解Nvidia GPU的硬件底层架构,总是有用的。 还记得大二时,第一个SRTP项目就是CUDA加速的GNSS信号软件接收机的算子开发。 虽然当时做的工作实际上就是最简单的AllReduce优化,但是在当时Vibe Coding还只是初露头角,学习起来还是挺费劲的。 没想到现在LLM大人已经能把算子开发工作做的炉火纯青了,真是
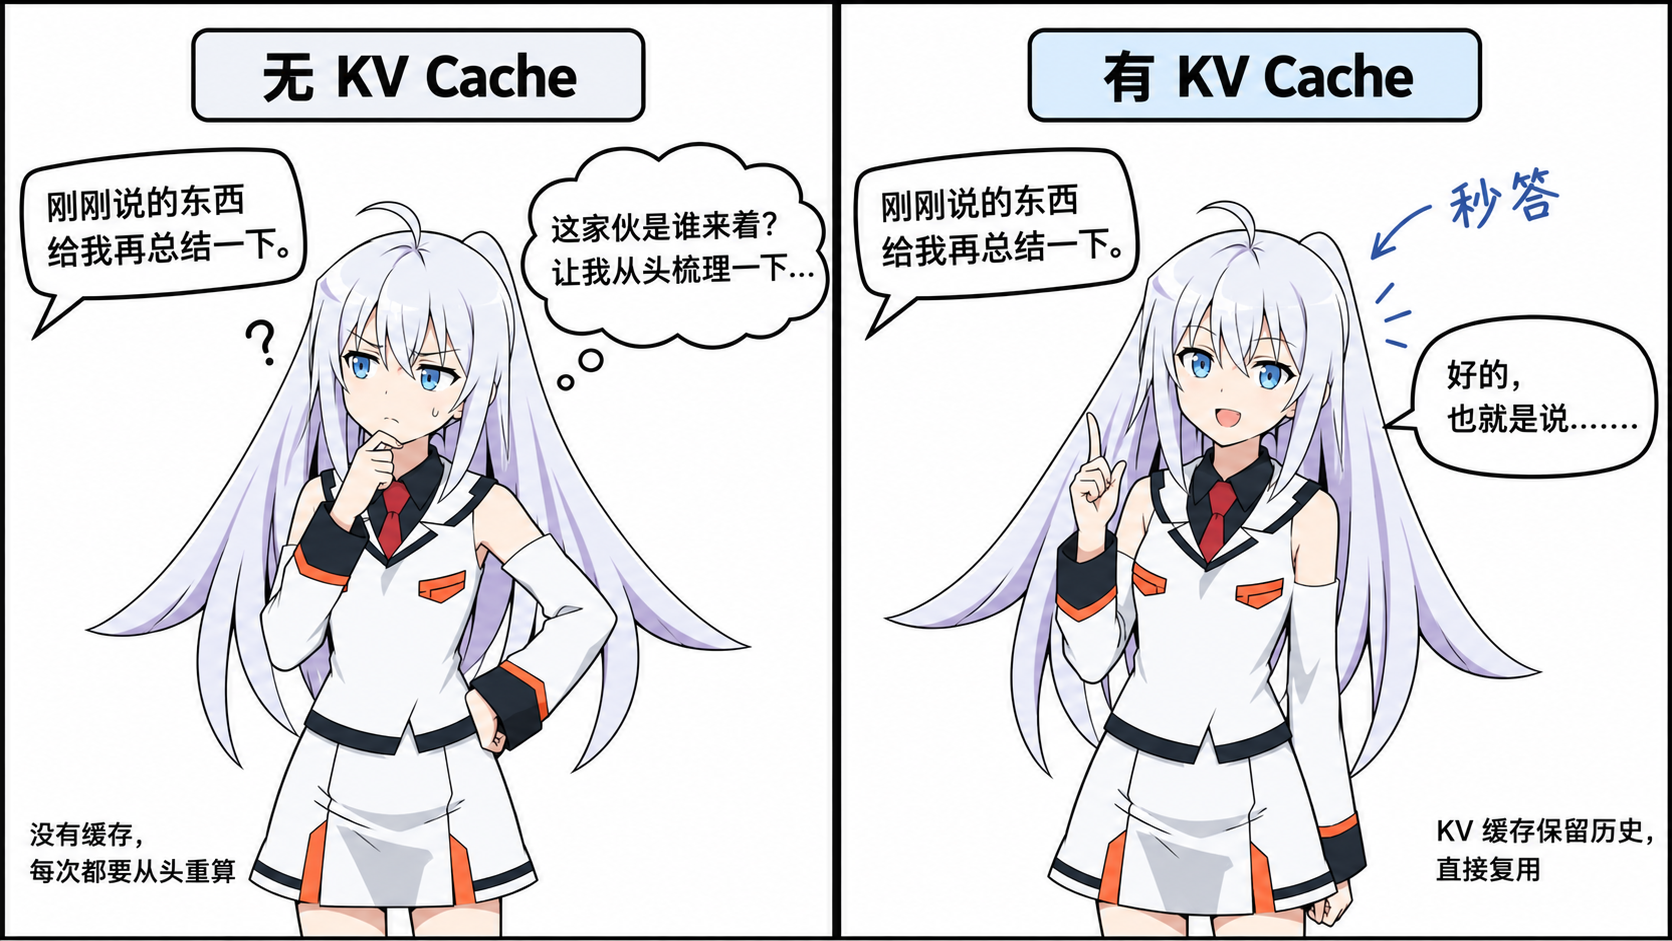
KV Cache 最近拜读了Cache Blend方法的KV Cache预处理方法,对这方面的处理大受震撼,趁着导师还没派发任务,写篇文章重新回看一下KV Cache,虽然这个技术本身不是什么复杂的事情(甚至很难说是一个“技术”),但对于推理加速和长对话推理优化的会议论文来说,大部分KV Cache上的工作仍然让人觉得常看常新。 KV矩阵——越来越多的计算量 还是说到推理上,推理分为两阶段:Prefill和Decode,前者主要负责批量计算前文Tokens的注意力模块的Key、Value矩阵。是典型的Compute Bound。对话越长,计算量也越大。 $$Q_{compute} 
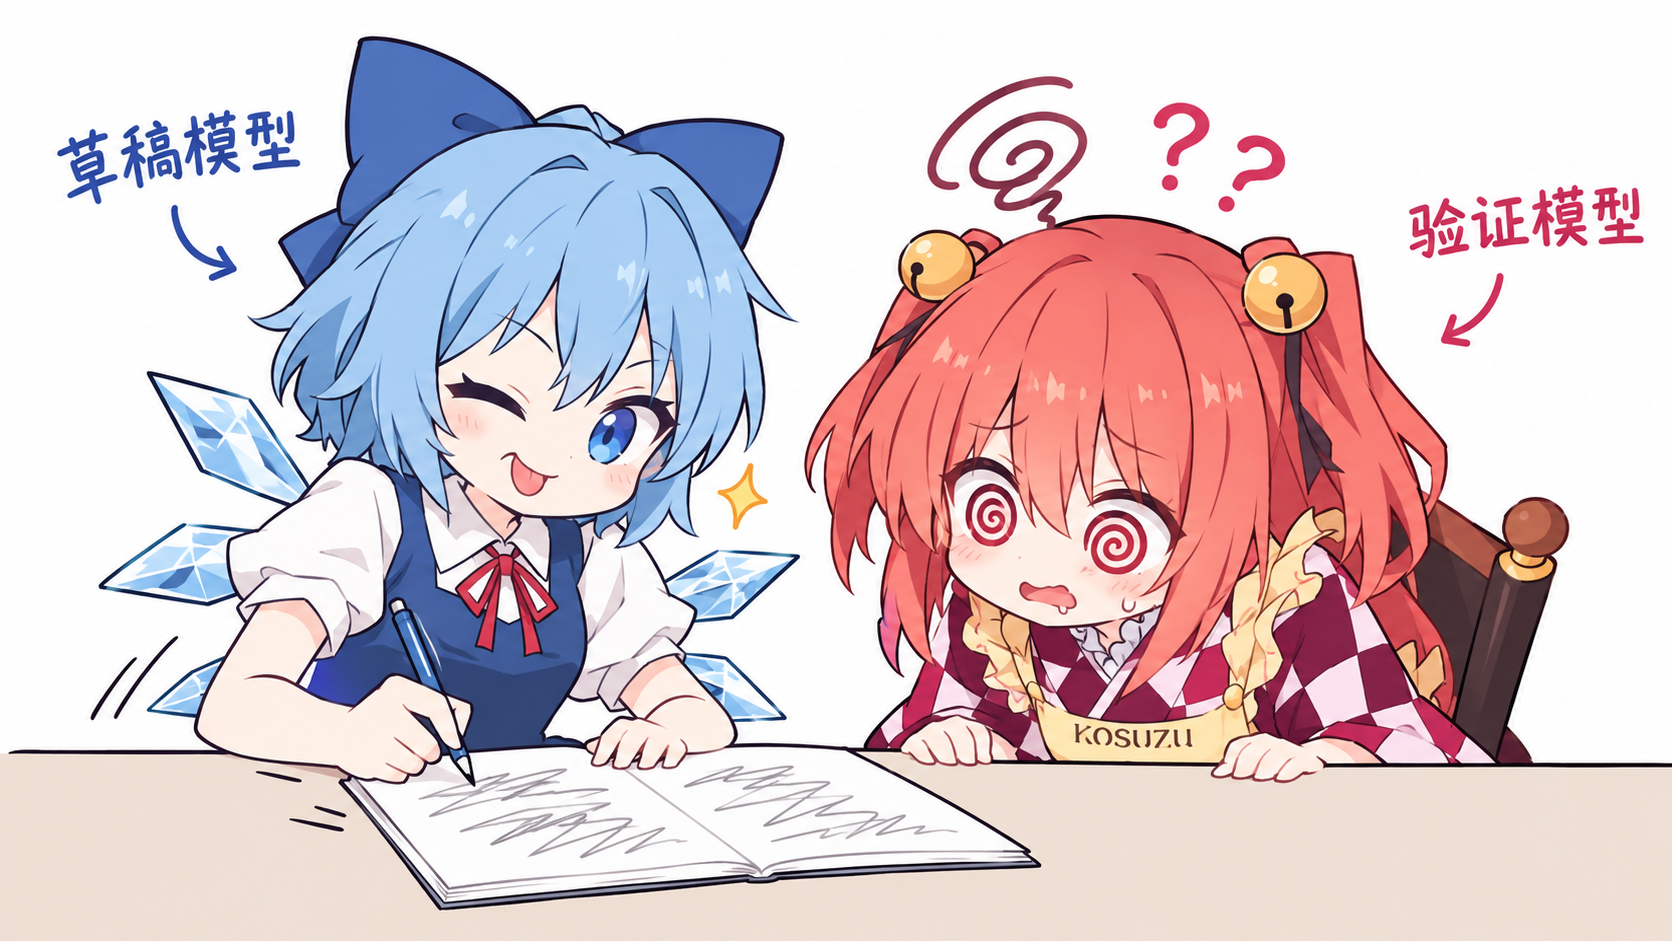
投机解码 现代LLM的工作阶段一般分为预填充(Prefill)阶段和推理(Decode)阶段。 前者是GPU发挥最大算力的最佳阶段,而后者从token序列的角度上来看,是逐token串行的,因此前向传播退化为矩阵-向量乘法,GPU实际上计算单元是空闲的。 这也是为什么实际工业提出了PD结耦的概念:当Prefill阶段需要更多计算单元(compute-bound)、Decoder阶段需要更大带宽时(memory-bandwidth-bound),将两者放在各自适配的设备上明显更加合理。 当然,本文主要讨论投机解码的解决方式,聚焦于投机解码是如何解决一般推理过程中计算单元的利用率问题,以及如