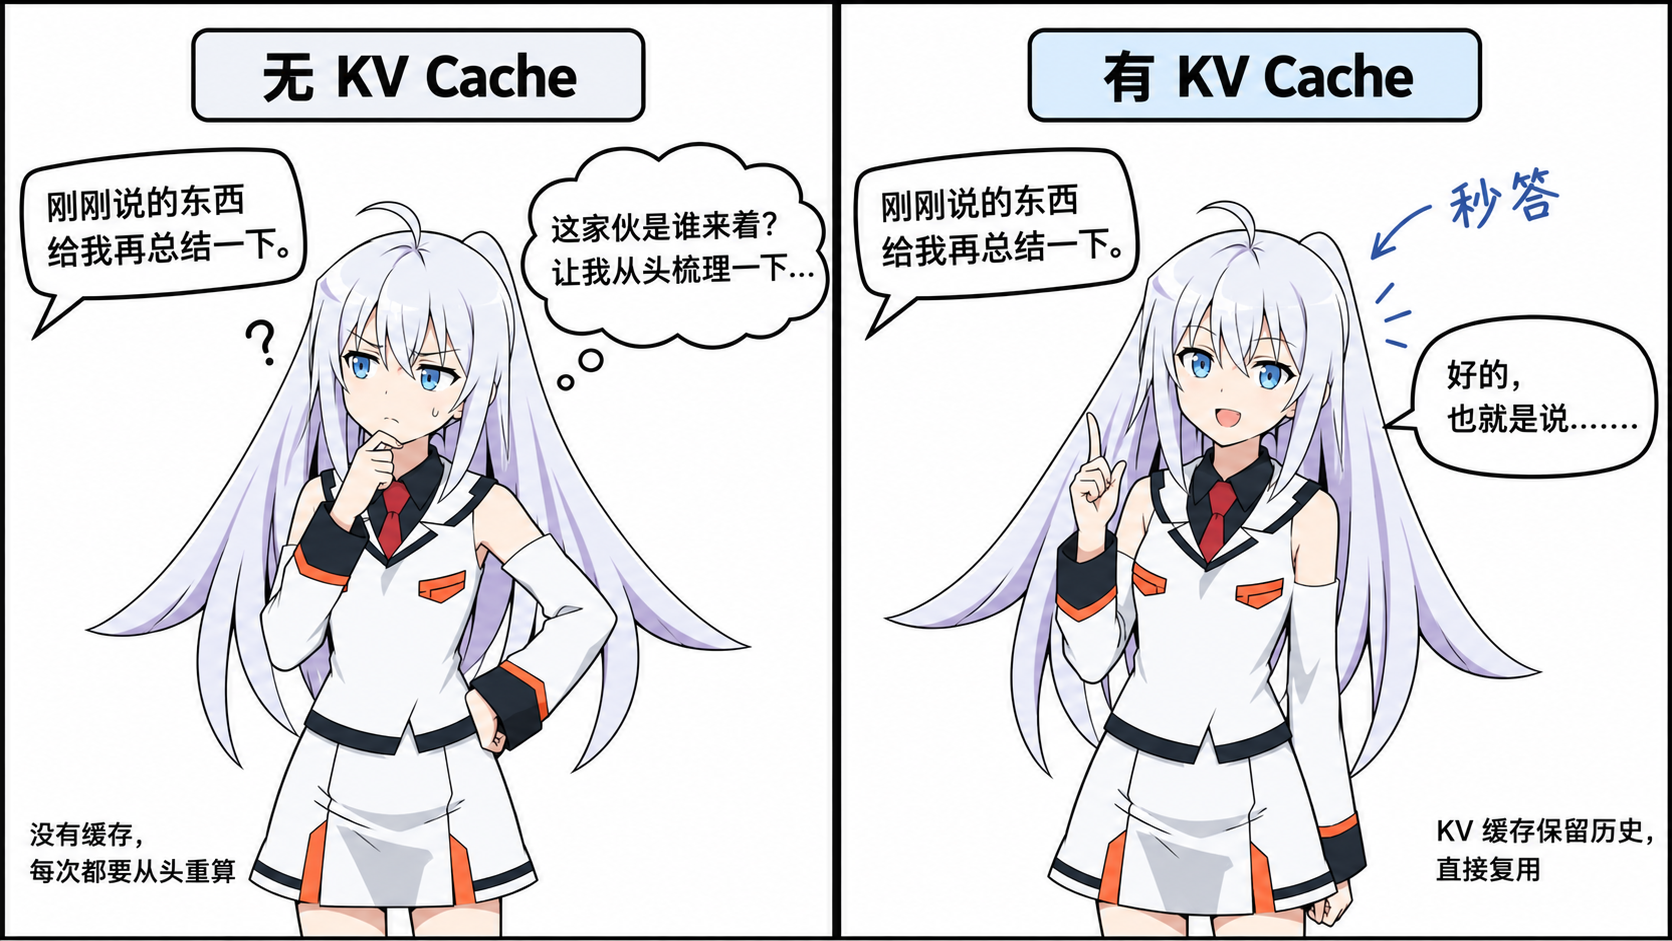
KV Cache
最近拜读了Cache Blend方法的KV Cache预处理方法,对这方面的处理大受震撼,趁着导师还没派发任务,写篇文章重新回看一下KV Cache,虽然这个技术本身不是什么复杂的事情(甚至很难说是一个“技术”),但对于推理加速和长对话推理优化的会议论文来说,大部分KV Cache上的工作仍然让人觉得常看常新。
KV矩阵——越来越多的计算量
还是说到推理上,推理分为两阶段:Prefill和Decode,前者主要负责批量计算前文Tokens的注意力模块的Key、Value矩阵。是典型的Compute Bound。对话越长,计算量也越大。
$$Q_{compute} = dim \times N_{Tokens} \times Layers $$
即Attention层数、隐藏维度决定了Attention模块中线性增长的速度(此处省略了FFN的计算)
虽然在Decode计算过程中,会出现累死累活就为了提升计算设备的利用率来提升效率的任务,但在Prefill阶段,计算量直接影响了首个Token返回时间TTFT,直接决定了用户收到回复的延迟。
此处再讨论一下TTFT和TPOT的关系,前者被用户感知为"什么时候开始被回答",后者则是"回答的流畅度"。
总时间为:$$T_{单次对话} = TTFT + N_{tokens}\times TPOT $$
特别对于输入长于输出的短对话来说,TTFT的优化是有很大意义的。
一个很现实的问题就是:LLM的服务是基于对话的,用户每发送一个请求,本质上是把所有的上下文信息打包一起发送的,这就是为什么LLM对话总是能丝滑的在搁置了很久之后正常工作:模型本质上只是在续写一长串的对话历史而已,对话越长,Prefill计算量越大,TTFT越来越长,workload也随之增长。
Decode阶段的KV Cache
Decode阶段,新的token的KV向量会被接续到Prefill的KV矩阵中存储,这也就是最开始的KV Cache:
1 | def generate(self,request): |
这是KV Cache最简单的状态:一次对话进行一次prefill,decode时复用。
我们可以说,这一KV Cache是“免费”的,反正decode阶段在时间上是连续的,没有不用的道理,而这付出的空间也是无法省略的:重新计算虽然可以动态的逐个KV按分片重算,但省下来的空间完全不如算力昂贵。
因此可以下一个结论:Prefill产生的KV矩阵在整个请求的生命周期内必须被缓存,请求结束后是否保留则取决于其他策略
前缀KV Cache
从Decode结束开始,我们就可以开始考虑什么时候应该丢弃掉这些KV Cache了,理由很简单:
KV Cache不再是“免费”的了,我们不知道什么时候对话会结束,无期限的存储不一定能用上的KV Cache很明显是个Bad Idea。
但另一个Cache方向凸显了出来:前缀 Cache
关于前缀Cache,可以以vLLM的Paged Attention和SGLang进一步的Radix Attention作为学习参考,前者是MLSys的经典之作,也是System经典思想的产物。
vLLM
Paged Attention的前缀技术并不是它的重点,但vLLM中基于Paged Attention基础上的前缀KV Cache的实现还是很有意思的。
Paged Attention将KV Cache按页表的形式进行分配,一个对话的KV Cache可以被划分为几个页进行存储(譬如16token为一页),这一设计最突出的特征是能够减少内存碎片:因为推理引擎不知道Decode的具体长度,短小的回复将导致预先分配的大块内存被浪费。这个问题与操作系统的内存分配也很相似,因此Paged Attention应运而生。
那么vLLM如何实现前缀Cache呢?主要是基于块的前缀哈希。即通过请求预先分块,并计算每个分块点的哈希值进行查找,来确定最长可复用KV Cache。
譬如两个KV Cache分支和一个请求的匹配:
|This is sentence|->|A, and |->|…|
⨽>|B, and |->|…|
请求为:
This is sentence A, and … 会被按块划分为|This is sentence||A, and ||…|并计算哈希,来查找是否有对应Cache。
当然,这种方法存在一个显而易见的粒度问题,譬如边界块|This is the||end.|的最后一个KV Cache不会被|This is the||end. Just kidding|复用,因为后者按块划分之后,最后一个块的前缀哈希与边缘块不同,必然不会被匹配。当然,vllm也针对这种问题做了处理:未满一页的尾块将不做缓存。
SGLang
SGLang的Radix Attention中,使用了前缀树,是专门针对KV Cache复用而设计的。
首先要声明的是,Radix Attention也使用了页表思想,因为这和前缀树并不冲突。RadixAttention在逻辑上使用基数树组织KV Cache,而物理内存分配仍然沿用了类似页表的管理,即最小的内存分配单位以页的形式组织。
Radix Attention的前缀树实现的是逐Token粒度的KV Cache复用,每一个节点都是不定长的前缀,每一个分支都对应了实际的KV Cache分支,并且是细粒度的。
即譬如|… is a good boy|和|… is a good girl|会划分为|…is a good|以及它的两个子节点|boy| |girl|
当然,结合上文提到的页思想,也很容易意识到,这种划分会导致由原本可以以两个物理页(|… is a good girl|+|… is a good boy|)表达的KV Cache被三个物理页(|…is a good|+|boy|+|girl|)表达,这实际上是一种完全可以接受的权衡:单一块的开销跟长上下文的块相比几乎可以忽略不计。
CacheBlend
CacheBlend是一个针对预计算KV Cache的拼接的研究。譬如一个使用了多个SKILL的请求,由于先后的堆叠,直接拼接KV Cache将会有糟糕的性能下降问题。
多说无益,这里直接复用论文中的图片

从这篇论文中可以看到,除了实际Prefill产生的KV Cache以外,还有对于关于预计算、选择性计算等技术能够提升KV Cache的性价比。
总而言之,KV Cache上能做的工作实际上有很多,虽然大部分的速率上的优化实际上都是有损的(与顺序计算全量KV Cache相比).
但本质上大部分有损的优化都可以和GQA、滑动注意力窗口等设计一起看作是关于速度和精度的平衡。
参考资料
- Efficient Memory Management for Large Language Model Serving with PagedAttention
- Efficiently Programming Large Language Models using SGLang
- CacheBlend: Fast Large Language Model Serving for RAG with Cached Knowledge Fusion
- Automatic Prefix Caching - vLLM Documentation
- vLLM GitHub Repository
- SGLang GitHub Repository